这篇文章不是教程,也不打算写成综述论文。
我更想借 Pi Agent 这个具体案例,和你一起顺着一条线聊下去: Agent Harness → 专业 Agent → GeoAgent → AI + 地球物理。
读完你应该能回答三个问题:Pi Agent 到底是什么?地球物理这个领域为什么会天然适合 Agent?以及我们这群做地球物理的人,未来可能会和 AI 怎么合作?
从 “AI 写代码” 到 “AI 执行任务”
如果你最近一年持续在用 AI,你大概能感觉到一件事:大模型的应用形态正在悄悄换挡。
最早的时候,我们习惯把 LLM 当聊天机器人——你问一句,它答一段。再后来,Cursor、Copilot、Claude Code 这类 Coding Agent 火起来,模型不再只是"补全下一行代码",而是能直接打开项目、读文件、改代码、跑命令。再往后,Agent 的能力被进一步推到更一般的任务上:搜资料、整理文献、操作浏览器、调用 API、甚至自己跑一个完整的小项目。
换句话说,ChatGPT 时代的关键词是"回答问题",而 Agent 时代的关键词正在变成**“执行任务”**。
那一个能"真正执行任务"的 Agent,到底由哪几块组成?我自己的理解是这样:
| |
这四件事合起来,就是现代 Agent 的最小可行形态。有意思的地方在于,模型本身往往不是最关键的——更关键的,是把它们捏在一起的那层"外骨骼"。
于是问题就来了:如果把这种"能持续执行任务"的能力,应用到地球物理领域,会发生什么?这篇文章想回答的,就是这件事。而我们的入口,是一个叫 Pi Agent 的开源项目。
Pi Agent 是什么?
Pi Agent 简介
Pi Agent 是一个开源的 Agent Harness(智能体执行底座),由 Mario Zechner(也就是早期 pi-android 的作者)发起。
它做的事情相当聚焦:给一个大语言模型提供完整的执行环境——文件读写、命令执行、工具调用、上下文管理、Skills 扩展、MCP 接入……所有这些原本要自己造轮子的部分,Pi 用一套很干净的最小实现给你准备好了。
一句话总结:
Pi 不是一个新的大语言模型,而是一个能让任意大模型"动起来"的 Agent 底座。
你可以把它理解成 LLM 的"操作系统",或者"手脚 + 短期记忆"。模型还是那个模型,但 Pi 让它有了真正做事的能力——能读你的 SEG-Y、能跑你的 Python、能保存中间结果、能根据报错重新尝试。
什么是 Agent Harness?
聊 Pi 之前,有必要先讲清楚 Agent Harness 这个概念,因为它会反复出现在后文里。
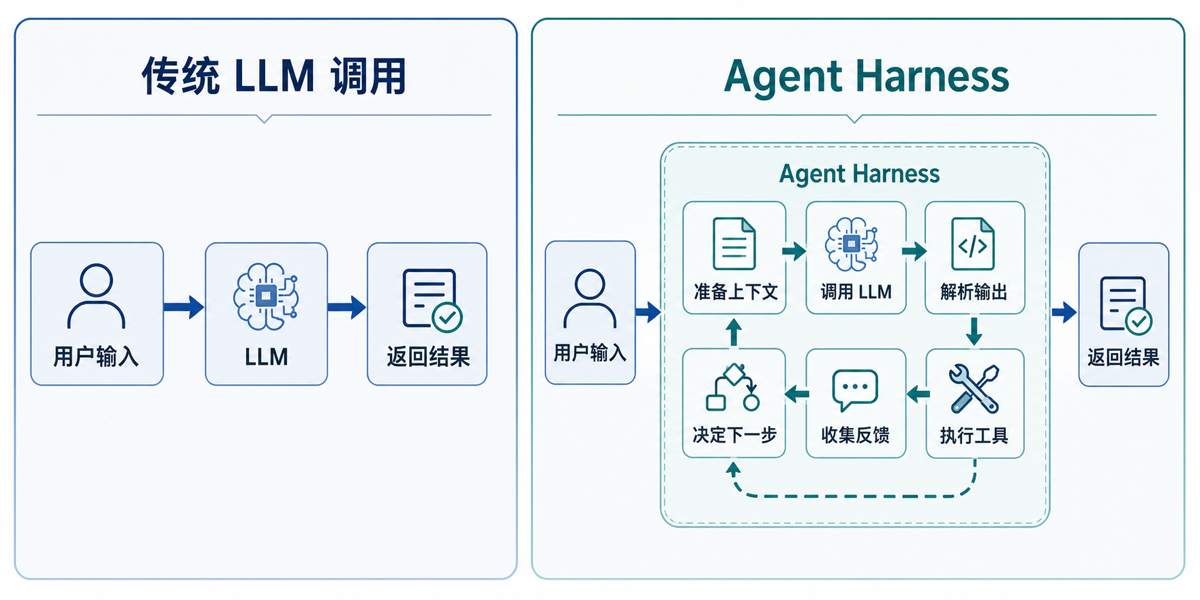
传统的大模型调用流程,其实很简单:
| |
这只是一个单次问答循环——你给一段输入,模型给一段输出,完事。但要让模型真正完成一项任务,就得在外面再包一层逻辑:
| |
这一整套"外层逻辑"就是 Agent Harness。它要负责维护会话状态、管理上下文窗口、提供工具接口、调度模型推理、处理重试与错误、还要把结果持久化下来。
做 Agent 的产品很多,但真正决定一款 Agent 好不好用的,往往不是它背后用的什么模型,而是这层 Harness 设计得怎么样。
Pi Agent 与传统大语言模型的区别
| 维度 | 传统 LLM 调用 | Pi Agent |
|---|---|---|
| 模型 | 固定 | 灵活,可对接多种模型 |
| 工具调用 | 需要自己写循环 | 内置完整循环 |
| 文件操作 | 无 | 原生支持 |
| 上下文管理 | 手动拼接 | 自动维护 |
| Skills | 无 | 内置 Skills 机制 |
| 扩展性 | 取决于开发者 | 通过 Extensions / MCP |
Pi Agent 的核心设计理念
Pi 的设计哲学可以概括成三句话:
第一,简洁优于复杂。它的 Harness 本身代码量很小,没有过度抽象,方便开发者读、改、定制。这一点我觉得对个人研究者特别友好——你不需要先去理解一整套复杂架构,就能上手改。
第二,可扩展优于封闭。Skills、Extensions、MCP 都是显式接口,可以自由组合。这意味着 Pi 不是一个"功能齐全但没法改"的成品,而是一个"够用、能改、能往上加东西"的底座。
第三,模型无关。它不绑定某一个模型,可以根据任务切换不同 LLM。
这种设计让 Pi 既适合作为通用 Agent 底座,也适合作为垂直领域 Agent 的起点——后面我们要展开的 GeoAgent,就是基于这个底座生长出来的。
Pi Agent 是如何工作的?
这一节我们不深入源码,而是用高层流程帮你建立直觉。如果你只关心"能拿来干嘛",完全可以跳过这一节。
一次完整的 Agent Loop
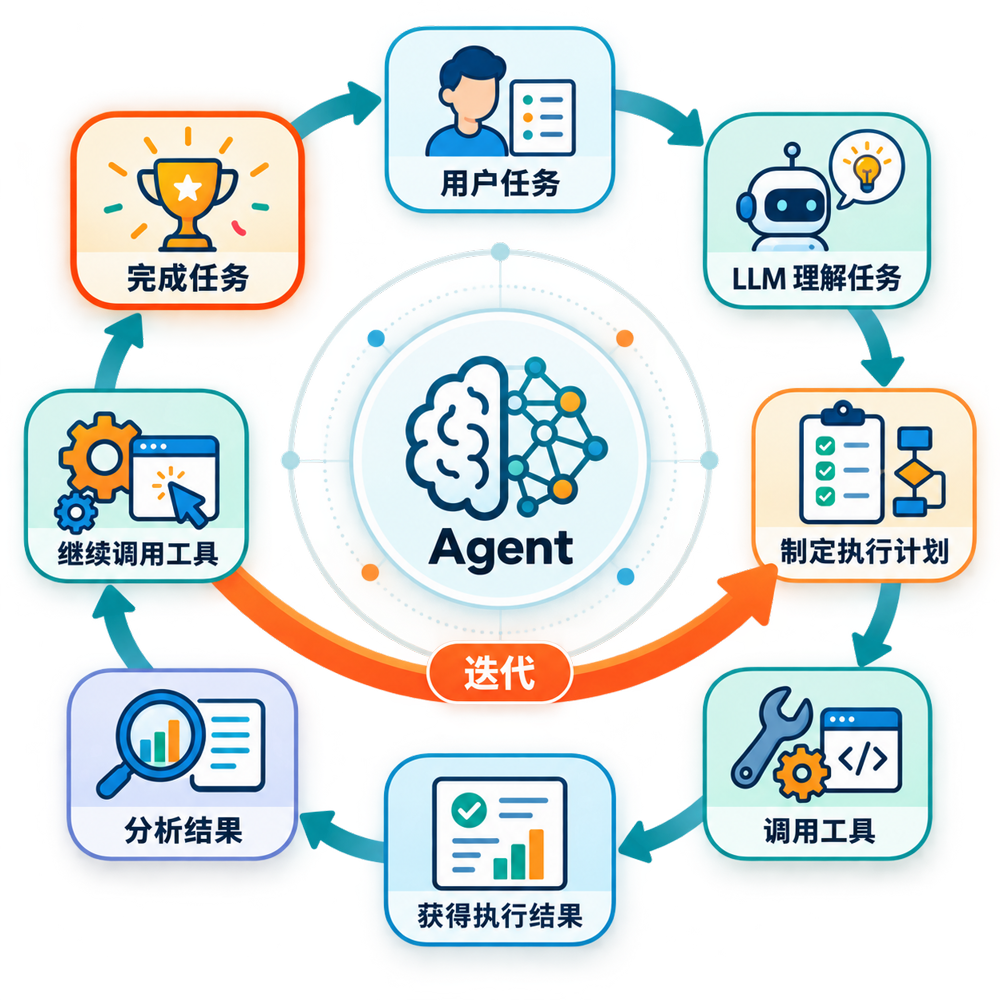
这个循环就是 Agent Loop。它的本质是:让 LLM 不只输出"答案",而是输出"下一步要做什么",再由 Harness 去执行,并把结果喂回来。
循环会一直跑,直到任务完成、达到最大步数、模型主动放弃、或者出现了不可恢复的错误。
Tool Calling(工具调用)
Tool Calling 是 Agent 与普通 ChatBot 最大的分水岭。
普通对话模型只能生成文本。但 Agent 的模型可以输出结构化的"工具调用请求",比如:
| |
Harness 接收到这个请求后,去真正执行这个工具,把结果——比如文件内容——作为新的上下文再次喂给模型。
工具的类型通常包括文件操作、命令执行、网络请求、代码执行、搜索等等。一个 Agent 能"听懂"多少工具,决定了它的能力上限。
Context 与 State(上下文与状态)
大模型的上下文窗口是有限的。但 Agent 在执行多步任务时,会不断累积历史对话、工具调用记录、工具返回结果、中间推理过程……内容很快就爆掉了。
Pi 会在内部维护一个 Context Window,并且在需要的时候做几件事:压缩早期历史、摘要长文件、移除冗余信息、重新组织提示词。这就是 Agent 的"短时记忆"。
Skills(技能)
Skills 是 Pi 的一大特色,也是后面 GeoAgent 故事里的关键角色。
它允许你把"一组完成某类任务的指令 + 工具组合"打包成一个可复用的单元。比如:
| |
模型在执行任务时,可以根据需要自动加载合适的 Skill。换句话说,Skill 是一种把"领域知识"显式编码进 Agent 的方式。
Extensions(扩展)
如果说 Skills 是"指令包",那 Extensions 就是"能力包"。
Extension 是一些可以被 Agent 调用的额外功能模块,比如数据库连接器、特定文件格式解析器、专业计算引擎、第三方 API 包装。通过 Extension 机制,Agent 可以在不修改核心代码的前提下获得新能力。
MCP 与外部工具
MCP(Model Context Protocol) 是 Anthropic 提出的一套开放协议,用来标准化 LLM 与外部工具/数据源之间的连接。
通过 MCP,Agent 可以接入本地服务、调用远程数据库、连接专业软件、读取知识库。对于地球物理这种需要和很多专业软件打交道的领域,MCP 提供了一种相当友好的扩展方式。
为什么地球物理领域适合 Agent?
聊完了 Pi,我们换一个视角:地球物理这个领域,到底有没有 Agent 施展拳脚的空间?我自己的答案是:非常适合,而且比很多领域都更适合。下面我从三个角度解释为什么。
地球物理工作的天然"长链路"
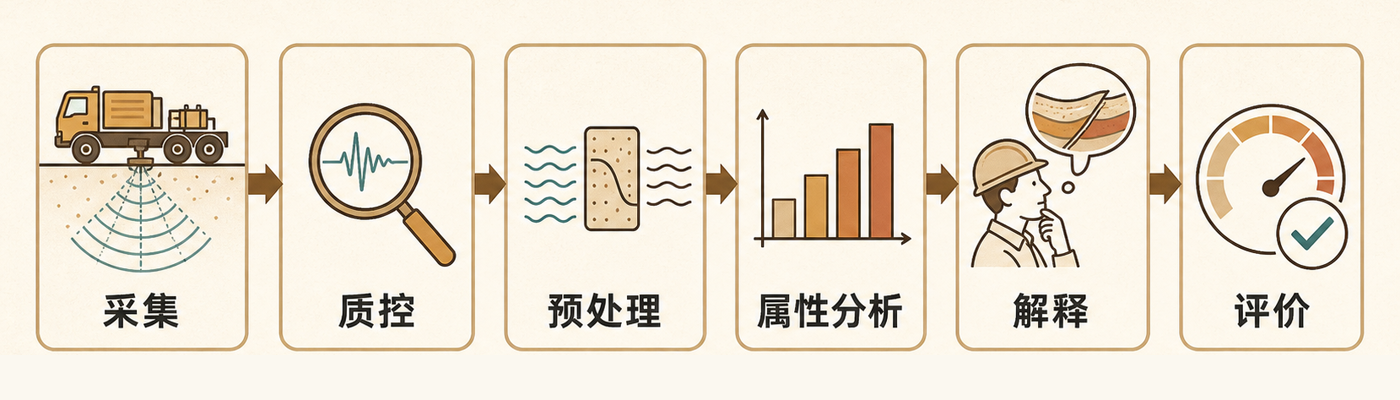
地球物理是一个非常典型的"长链路学科"。一次像样的科研或生产任务,几乎一定要走完"采集 → 处理 → 解释 → 评价"这一整套流程。中间任何一个环节出问题,最后的结论就可能站不住。
以地震为例,一个完整的处理流程通常是数据进来、先做质控、然后预处理、跑属性、解释、最后再做一轮结果评价。测井也类似,从质量控制到数据处理,再到特征分析、建模、评价,几乎是一模一样的形态。
这种多步骤、可迭代、强反馈的工作方式,天然契合 Agent 的"理解任务 → 调用工具 → 获取结果 → 判断 → 再执行"循环。换句话说,地球物理学家本来就在用一种类似 Agent 的方式工作,只不过过去这个 Agent 是人脑 + 鼠标 + 一堆 shell 脚本。
数据、软件、代码的高度协同
如果你在地球物理行业待过一段时间,应该会有一个明显的感受:没有哪一款软件能搞定所有事。
典型的组合是:专业地球物理软件 + Python 生态(numpy、scipy、pandas、PyTorch)+ MATLAB + QGIS + 数据库 + 一堆自研脚本和内部工具。把这些东西粘合起来,往往需要写大量"胶水代码"。这种胶水代码通常很丑、很重复、还很脆弱——改一个文件名就要动三个地方。
而 Agent 的天然能力之一,就是跨工具调度。当你用自然语言描述"读取 SEG-Y、过滤异常、写入 CSV、画张图"的时候,Agent 可以自己决定该调哪个工具、用什么参数、把中间结果放在哪。这件事对地球物理这种"工具大杂烩"的场景,价值格外明显。
多步骤科研任务与 Agent 的天然契合
科研任务的几个典型特征——目标常常一开始不明确、中间需要反复尝试、参数要不断调整、结果需要反复可视化、失败之后要回溯与重试——和 Agent Loop 的工作方式,几乎是一一对应的:目标不明确就多轮对话澄清需求,需要反复尝试就用 Tool Calling 的重试机制,参数要调整就让模型根据反馈修改输入,失败要回溯就让 Harness 保留完整日志。
这不是巧合。Agent 的工作模式,本来就是从科研流程里抽象出来的。
Pi Agent 在地球物理领域能做什么?
这一节是文章最"实在"的部分。我们从几个典型方向聊聊,但不绑定任何一个具体项目。
下面的应用里,有些现在已经可以做到,有些还在路上。Pi 本身不带任何地球物理能力,但作为底座,它让所有这些应用都变得可能。
地球物理数据智能质控
数据质控(QC)是地球物理工作的第一步,也是最重复、最容易出错的一步。我自己读研那会儿,最不想做的就是"读 SEG-Y 检查道头"这种活儿——枯燥、机械、但又必须做。
Agent 在这个场景下能做的事情非常直接:自动读取 SEG-Y 检查道头是否完整、自动读 LAS 检查曲线是否齐全、自动统计采样率与坐标、自动检测异常值和空段、自动画出直方图与分布图、自动输出 QC 报告。
整个过程大致会走这条链路:读取数据 → 分析数据质量 → 发现异常 → 调用 Python 跑统计 → 生成 QC 图表 → 输出报告。
举个例子,你直接对 Agent 说"帮我检查一下 /data/3d.sgy 这个地震数据体,重点看道头完整性、采样率一致性、有没有空道",它就会自己跑完这一整套流程,把结果摆在你面前。这种"把你从机械 QC 里解放出来"的价值,其实比很多人想象的大——QC 的标准一旦参差不齐,后面所有分析的可靠性都会打折扣。
地震资料处理辅助
地震资料处理是另一个 Agent 可以深度参与的方向。它可以承担数据格式转换、预处理(滤波、增益、去噪)、频谱分析、信噪比估算、速度分析辅助、地震属性提取、不同处理方案的批量对比这一类任务。
不过这里我特别想强调一个原则:
Agent 的目标是"辅助",不是"替代"。
地震处理是一个高度依赖专业判断的工作,处理参数的每一次调整,背后都有一套地质假设。Agent 更适合承担那些重复性高、规则明确、有清晰评价指标的子任务——比如批量跑几种滤波参数然后做对比图、比如把一个工区所有 SEG-Y 的采样率统一对齐。关键参数的选择、地质含义的判断,仍然必须留给地球物理学家。
测井数据智能分析
测井数据有一个特别适合 Agent 的特点:它天然是结构化的——井名、深度段、曲线名都是规整字段,不像地震道数据那么"野"。这意味着 Agent 在拿到 LAS 文件后,几乎不需要太多先验知识就能完成解析、清洗、统计这些基础工作。
在测井场景里,Agent 可以承担 LAS 解析与字段映射、曲线质量评估、缺失值处理、多井数据对齐、交会图分析、测井参数统计、机器学习建模(岩性识别、储层预测)这一整套任务。它可以扮演的角色,更像是"智能数据分析师"——你告诉它一口井或一个工区的基本要求,它自己把数据拉通、把图出好、把模型跑完,最后把结果连同置信度一起交给你。
地球物理机器学习实验自动化
如果你做过一段时间地球物理 + 机器学习的交叉研究,应该会对"调参地狱"深有体会——改一个超参数就要重新跑一轮训练、再画一次 loss 曲线、再统计一次指标、再写一段对比文字。这种循环跑个几十次,人就开始麻了。
而这恰恰是 Agent 最擅长的事情。把实验需求交给 Agent 之后,它可以自动准备数据、划分数据集、修改超参数、运行模型、计算评价指标、生成对比图表、比较实验结果、整理实验日志。Agent 在这里不是替你做研究,而是替你"重复你自己"。
我自己的感受是:很多时候,一个研究方向能不能推进下去,不取决于研究者能不能想出新点子,而取决于他愿意花多少精力在重复劳动上。Agent 把这部分精力压缩下来之后,研究者就能把更多时间花在"这个实验到底在回答什么问题"上。
多软件与多工具协同
地球物理工作者经常要在多个软件之间来回切换。Pi 作为一个 Agent 层,可以把这些工具统一抽象起来:
| |
你只需要用自然语言描述需求,Agent 负责调度合适的工具完成任务。比如你可以说"把 SEG-Y 数据中所有振幅大于阈值的采样点位置导出到 QGIS 中叠加在井位上",Agent 会自己决定:先读 SEG-Y → 做阈值过滤 → 转坐标 → 写 Shapefile → 在 QGIS 里加载并叠加。这种"跨工具一气呵成"的能力,是 Agent 给地球物理工作流带来的最大变化之一。
地球物理科研辅助
在更宏观的层面,Agent 还能承担科研助手的角色:文献整理与摘要、实验设计建议、参数敏感性分析、结果可视化、研究过程记录、报告初稿生成。
这里我想稍微泼一点冷水:Agent 不太可能直接替你产出最终论文,但它能极大降低机械性工作的负担。事实上,大多数科研项目的瓶颈,并不是"AI 不够聪明",而是"研究者花在非创造性工作上的时间太多"。把这一块腾出来,研究者才有空间去做真正有价值的事——定义问题、设计实验、解释结果。
从 Pi Agent 到 GeoAgent
到这里,我们可以抛出一个新概念:GeoAgent。
它不是 Pi 的简单"地球物理插件",而是一种面向地球物理领域的专业 Agent 形态。Pi 提供了通用的 Agent Harness,而 GeoAgent 在 Pi 之上封装了地球物理领域真正需要的东西:专业知识、专业工具、专业流程、专业规范。
专业知识、Skills 与 Tools
GeoAgent 的核心可以拆成三块:
| |
这三块缺一不可:专业知识 决定 Agent 能不能"听懂"地球物理任务;Skills 决定 Agent 能不能"按规范"执行专业流程;Tools 决定 Agent 能不能真正"动手"调用工具。
举个我自己的例子:如果一个 Agent 没有地球物理知识,它可能拿到 LAS 文件后只会输出"这是一个 CSV";如果它有了地球物理知识但没有 Skills,它知道这是 LAS,但不知道该先做哪些 QC;如果它两者都有但没有 Tools,它会告诉你该做什么,但自己干不了活。三块都到位,GeoAgent 才能真正跑起来。
GeoAgent 的基本架构
一个参考性的 GeoAgent 架构大致长这样:
| |
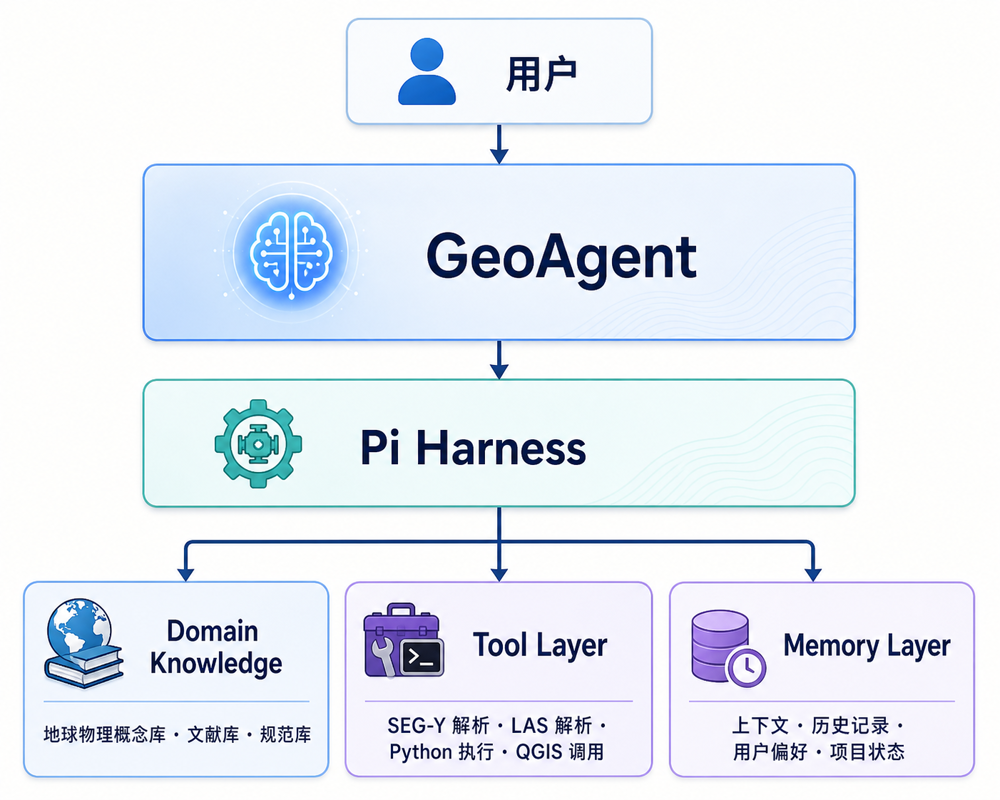
其中 Domain Knowledge 层负责"听懂任务",Tool Layer 负责"调对工具",Memory Layer 负责"记住上下文"。这三层加上 Pi Harness 这个底座,就构成了 GeoAgent 的最小骨架。
从任务执行到科研闭环
理想中的 GeoAgent 不只是"执行单次任务",而是能够形成完整的科研闭环:
| |
这一步也是 GeoAgent 区别于"自动化脚本"的根本所在:它能根据结果自主调整策略,而不是机械地按预设步骤执行。脚本是死的,Agent 是活的——前提是它确实理解任务目标,并且有足够的工具支持。
GeoAgent 可以发展成什么?
如果你认同 GeoAgent 这个方向,那下一步自然会问:未来 GeoAgent 会变成什么?我自己想象的是,它会进一步分化成多个垂直智能体,形成一个"专业 Agent 集群"。
这一节我不会给每个 Agent 列一堆功能清单,而是讲讲它们各自"像什么"——具体形态留给以后的探索。
如果把 SEG-Y 想象成一摞厚厚的体检报告,那 Seismic Agent(地震智能体) 就像是那个会自动跑完所有基础检查、并把可疑的地方标红提醒你的助手。它最擅长的事情,其实是那些"地球物理学家不愿意干第三遍"的活儿:批量检查道头、统计采样率、跑一遍频谱分析、在不同处理方案的输出上画对比图。它不一定能替你判断哪个同相轴是断层、哪个是河道,但它能保证你在做判断之前,手里所有的基础数据都是干净、对齐、可信的。这种"替地球物理学家守住第一道质量关"的角色,可能是 Agent 在生产单位最先落地的形态。
Well Log Agent(测井智能体) 则是另一个故事。前面说过,测井数据天然是结构化的,井名、曲线名、深度段都是规整字段。这意味着 Agent 在拿到 LAS 文件后,几乎不需要太多先验知识就能完成解析、清洗、统计这些基础工作。一个成熟的测井智能体,可以负责把一个工区里几十口井的曲线统一拉齐、做完质量评估、自动出交会图和直方图,甚至把岩性识别、储层预测这类有标准建模流程的任务跑一遍,把结果连同置信度一起交给解释员。它不会替代解释员的最终判断,但会让他们从"翻文件 → 画图 → 对数据"的循环里解放出来。
Geology Agent(地质智能体) 处理的是另一类问题——它面对的主要不是结构化数据,而是非结构化的地质资料。地层划分、沉积相描述、构造解释结果、老井的试油结论……这些信息大多写在 Word、PDF 或者纸质报告里。地质智能体的核心价值就在于"把这些非结构化资料变成可计算的知识"——把文字描述拆成结构化字段、把图件和地震层位对齐、把不同年代不同来源的报告汇总成一份当前可用的工区知识库。当一个地震智能体的结果需要和地质解释对照时,地质智能体就能直接提供上下文,而不需要解释员再去翻箱底的报告。
在这三个"专业 Agent"之外,还会存在一个更通用的 数据分析智能体。它不专属于地震、测井或地质,而是横跨这些方向,负责"把数据变成图表、把图表变成信息"的中间环节:缺失值处理、异常值识别、特征工程、可视化、机器学习建模……所有"调包 → 调参 → 出图"的循环,它都能接手。在实际项目里,它可能是和具体专业 Agent 并列存在的——专业 Agent 负责"专业判断",数据分析智能体负责"工程实现",二者协同工作。
最后,还有一个贯穿全局的角色:科研智能体。它可能并不直接处理数据,但它会负责实验设计、参数扫描、结果汇总、文献管理、报告初稿这些"科研项目本身的工作"。如果你做过一段时间科研,一定会有那种感觉:真正想清楚"该做什么实验"比"把实验跑出来"更花时间。科研智能体的目标不是替你做决定,而是"在你做决定之前,把所有可能的选项都铺好",让你能在更高的层面上思考科学问题。
把上面这些角色拼起来,未来地球物理科研的样子可能是这样的:
| |
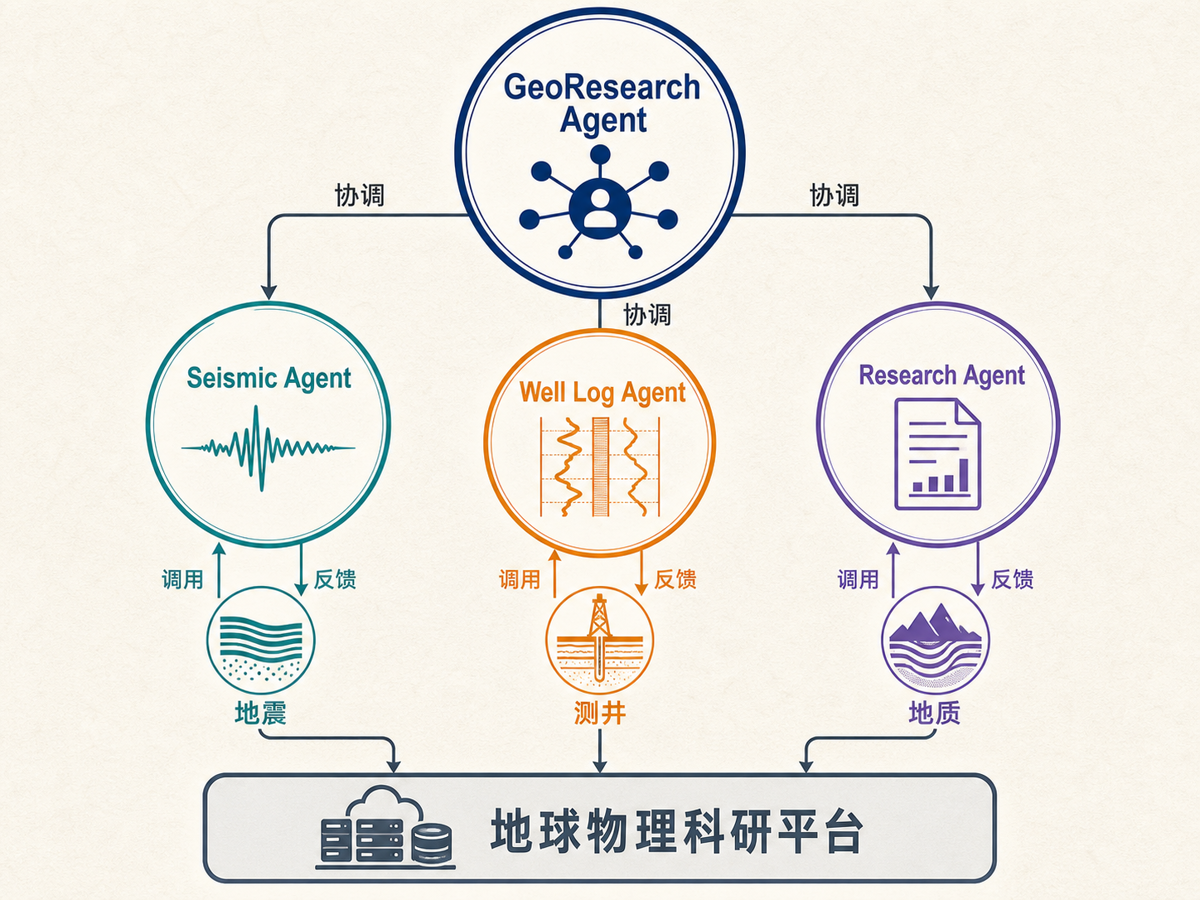
多 Agent 协同,而不是单一 Agent 包打天下——这一点我觉得很重要。地球物理本身就是一个高度分化的学科,让一个通用 Agent 同时精通地震、测井、地质、机器学习、科研写作,是不现实的。让多个专门 Agent 各司其职,再用一个"上层协调者"组织起来,会是更稳健的路径。
Agent 会取代地球物理专业人员吗?
这是一个绕不开的问题。我的回答是:不会,但会改变他们的工作方式。
Agent 擅长的事情,其实相当具体。它可以不知疲倦地做数据处理与清洗,把重复性任务自动化;它能在几分钟内完成原本要花一下午的信息检索与文献整理;它能写出可运行的代码片段并自己执行;它能替你运行实验、记录日志、整理文档草稿;它能在多款软件之间调度,把"在不同窗口之间来回切换"这种痛苦的事情压缩成一句自然语言。
但下面这些事,至少在可预见的未来,仍然牢牢掌握在人类专家手里。
地球物理问题的定义,就是什么值得研究、什么不必研究、什么是真正的科学问题——这件事没有任何 Agent 能替你做。它不知道你的项目要解决什么、你的数据有什么特殊性、你的合作方关心什么结论。方法选择与建模策略也是这样:面对复杂地质条件该用频域方法还是时域方法?该用监督学习还是自监督?这种判断,从来不是"模型越大越准",而是需要把物理直觉、数据特征、研究目标揉在一起权衡。地质解释更是如此——地震反射到底对应什么地质含义?一段异常的电阻率曲线背后是岩性变化还是流体变化?这种"看到数据 → 联想到地质"的能力,是地球物理学家十几年训练出来的肌肉记忆,Agent 离这一步还有相当距离。
更不用说 科学假设 和 最终决策——前者要求你有"提出新模型"的创造力,后者要求你为整个研究方向负责。这两件事,目前没有任何 AI 系统能独立承担。
所以更现实的模式,不是 “Human vs Agent”,而是 Human + Agent:
| |
人类负责定义问题、判断结果、承担责任;Agent 负责执行细节、提供选项、放大效率。 这条路看起来不够性感,但它是我能想到的、地球物理学科与 AI 结合的最稳健路径。
地球物理 Agent 面临的挑战
写到这里,文章好像一路在夸 Agent。但如果不把"目前还迈不过去的坎"讲清楚,这篇文章就和那些吹 AI 万能的文章没什么区别了。
第一道坎是幻觉。 LLM 可能会"一本正经地胡说八道"。在地球物理这种对数值与物理含义高度敏感的领域,幻觉可能是致命的——一个错误的采样率、一个错误的单位换算、一个被混淆的深度单位,都可能让整个分析失效。和写文章不同,地学数据里的错误不会因为"读起来像那么回事"就被放过。
第二道坎是工具调用的可靠性。 Agent 并不总是"做对事"。它可能误调用工具、可能传错参数、可能在错误的路径下写入文件、可能在循环里卡死。尤其在涉及专业软件时,一次错误的调用可能污染整个数据流——比如把错误的参数写进 SEG-Y 的道头。这种问题在通用场景下可能只是"操作失败",在地球物理场景下可能是"几个月的工作要重做"。
第三道坎是数据安全。 地球物理数据往往是高价值数据——油田、矿藏、勘探项目,背后是巨大的商业利益。Agent 在执行过程中需要严格的访问控制、数据脱敏、操作审计和异常行为告警。让一个 LLM 直接接触未加密的勘探数据,本身就是一件需要谨慎设计的事。
第四道坎是可解释性与可重复性。 科研要求可重复。但 Agent 的执行路径往往受 LLM 抽样影响:同样的任务两次执行,路径可能不同;中间决策难以完全追溯;输出结果可能存在微小差异。这需要 Agent 在日志、版本控制、随机性管理上做大量工程化工作——这件事说起来简单,做起来相当烦人。
第五道坎,也是最根本的一道:人类专家监督的必要性。 我把这句话单独写一次:
Agent 可以自动执行,不意味着 Agent 自动正确。
在专业领域,人类专家的最终监督不可或缺。任何由 Agent 产生的结果,都需要由地球物理学家结合地质背景与专业经验进行复核。这一点在可预见的未来都不会改变——也不应该改变。
展望:AI + 地球物理的新型科研范式
最后回到本文的主题。
未来地球物理科研的范式,可能会从今天这种形态——
| |
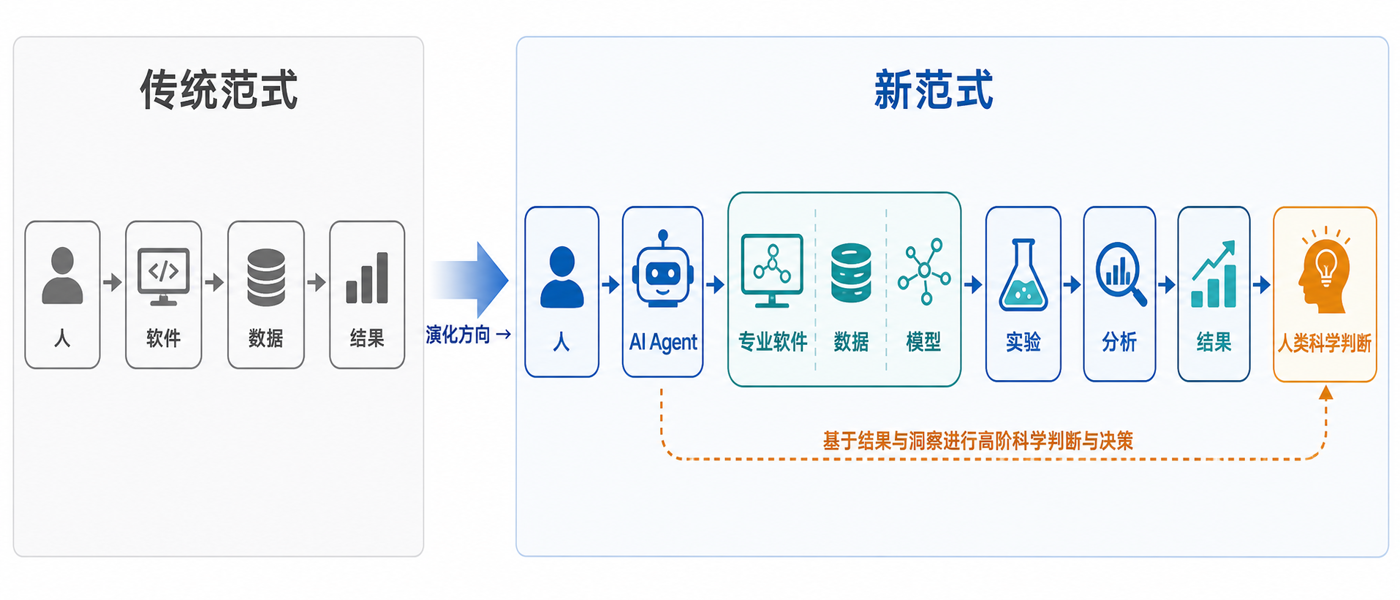
——逐渐演化成一种新的形态:
| |
更进一步,这种范式可以被称为 AI + Geophysics、AI-driven Geophysical Research,或者 GeoAgent-powered Exploration。
而 Pi Agent 这样的通用 Agent Harness,则是这条演化路径上的一个重要基础设施。它不是地球物理的答案,但它是让地球物理 Agent 真正跑起来的一层底座。
写在最后
回到文章开头的那句话:
Pi Agent 本身并不是地球物理解决方案。
但它提供了一种值得探索的 Agent 基础设施。通过专业知识、Skills、Tools 和数据的结合,我们可以一步步构建面向地球物理勘探、测井和科研工作的 GeoAgent。
这不是一篇教程,也不是一个开源项目介绍。它更像是一份技术方向的笔记——记录我对 Agent 与地球物理结合可能性的思考。
如果你也在思考类似的问题,欢迎在评论区聊聊你的看法,或者直接邮件交流。一个人琢磨容易钻牛角尖,多碰撞几次,方向才能慢慢清晰。
参考资源